

Написал комментарий к посту О виртуальной реальности и играх будущего
В таком случае всё ограничится игровой капсулой.
Заходил
В таком случае всё ограничится игровой капсулой.
Вспомните кто у нас получает визуальную информацию в мозгу и как. Человек имеет два зрительных нерва в каждом из которых от 770 000 до 1,7 миллиона нервных волокон. Простым нейроинтерфейсом тут не обойдётся.
Одно другому не мешает ни сейчас, ни в будущем.
Попробуем прокрутить фарш обратно
Как задал так и сделает, но есть нюансы. Поэтому обычно оно само додумывает.
Любая нейросеть сейчас плохо умеет в компоновочные изображения, поэтому у все трёх одинаковые эмоции на лице.
Модель кажется была Anything-V3.0
1girl, angel, angel_wings, armor, bird_wings, black_hair, black_wings, breasts, cleavage, demon_girl, feathered_wings, feathers, full_body, high_heels, horns, large_wings, long_hair, multiple_wings, single_wing, solo, spread_wings, wings, depth_of_field, forest, nature, outdoors, snow, solo, standing, tree, realistic, photo_\(medium\), photorealistic, (ultra-detailed:1.2)
Negative prompt: blurry, deformed face, deformed hands, deformed fingers, ugly, bad anatomy, extra fingers, extra hands, deformed eyes, logo, text
Steps: 20, Sampler: DPM++ SDE Karras, CFG scale: 7, Seed: 4081727502, Size: 512x512, Model hash: 6569e224
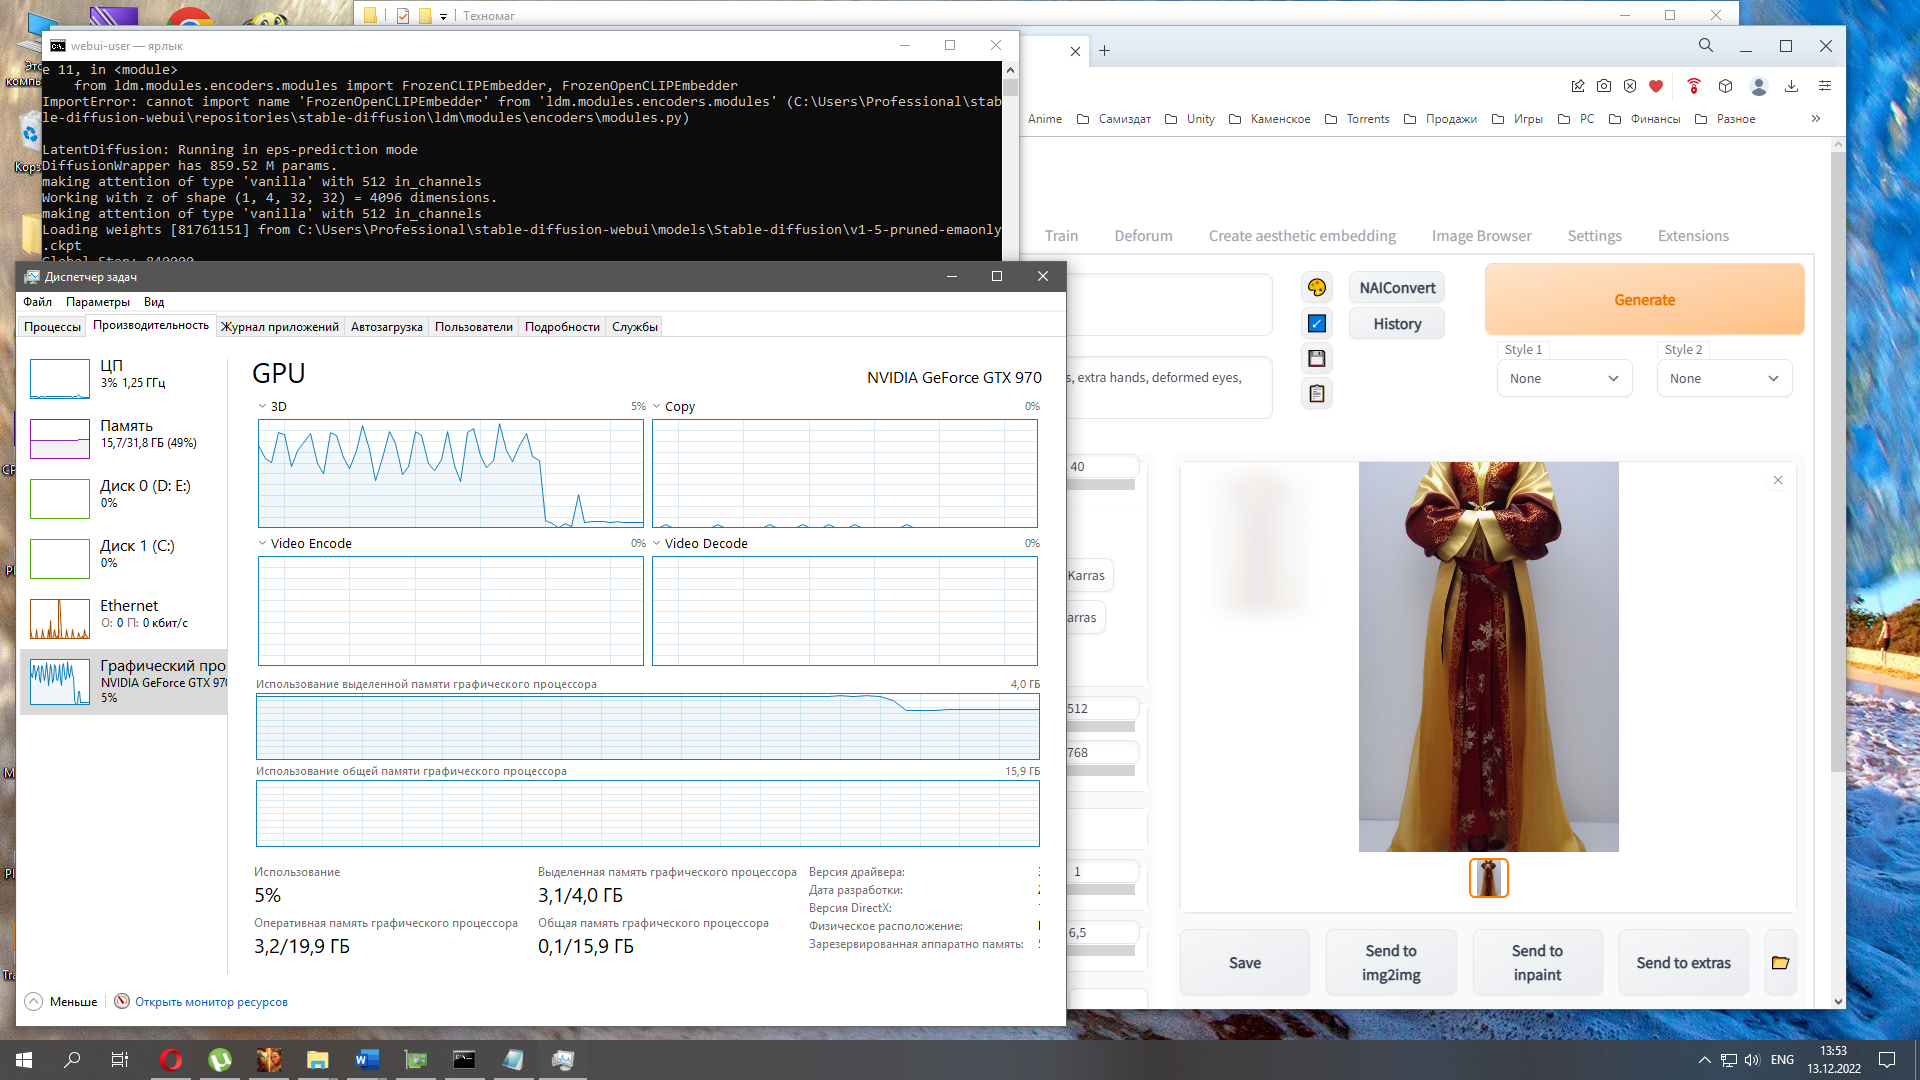
У меня она на GTX970 с 4 Гб вполне нормально работает
Уже есть робкие попытки прикрутить к нейросетям обработку видео
Нет. Именно на видеокарте.
Вы правы. Бета-ридер действительно нужен.
В своё время тоже купился на эльфийских женщин

Проблема не в нейросети, а в её требованиях. Например для Stable Diffusion нужно установить GIT, CUDA Toolkit, Python и ещё по мелочи
Первое, что приходит на ум по картинкам:
1 угол комнаты
2 и 3 мишени
Иногда нейросеть действительно может интересных "снегурок" сгенерировать 
Думаю, нейросетям не позволят подняться до уровня 3Д рендеров. Слишком уж они залезают на чужую территорию. Сильно не афишируют, но тут уже есть цензура. И она совершенно не касается порно.
Ага
А вы сами подумайте.
Как один из вариантов. Нейросеть позволяет генерировать реалистичную картинку. Берём лицо и тело реального известного человека. Фото видео материалов в сети достаточно для обучения нейросети. И дальше используем как нам выгодно. Только с созданием видео пока трудности.
п.с. Законодательно нейросети пока не регулируются
Вы ж учтите, что на картинку сильно влияют ещё и пропорции. Попробуйте тот же Промт но в 2:3 и 3:2
А какую нейросеть использовали?
stable diffusion вполне сносно их рисует

Воссоздавать, прям детализированные сцены из книг с помощью нейросетей - нет
Чем больше деталей и чем они меньше, тем хуже воспроизведение.
Проще из сотни генераций выбрать одну наиболее подходящую.
Да
portrait,sideface, masterpiece, best quality,
1woman, foreshortening, lips, photo_\(medium\), realistic, medium_hair, solo, green_eyes, woman_focus, blonde_hair, \(\(light_skin\)\), middle_age_woman, half-back hair, hair styled back, detailed light, HDR, extremely detailed, photorealistic, looking at viewer, light clothes, ((light skin)), upper body, rose_lips, Pointy ears, hair jewelry, jewelry
Negative prompt: lowres, bad anatomy, bad hands, text, error, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality, normal quality, jpeg artifacts, signature, watermark, username, blurry, artist name,
blurry, deformed face, deformed hands, deformed fingers, ugly, bad anatomy, extra fingers, extra hands, deformed eyes
Steps: 20, Sampler: DPM++ 2M Karras, CFG scale: 11.5, Seed: 1159680561, Size: 512x704, Model hash: 6569e224
Anything v3.0
Какая интересная модель однако
Спасибо. С интересом прочитал все три книги.
Иногда нейросеть выдаёт действительно забавные вещи.
У меня модели находятся по такому адресу:
C:\Users\Professional\stable-diffusion-webui\models\Stable-diffusion
Скачиваете туда файлы с расширением ckpt
Midjourney (берёте только файл mdjrny-v4.ckpt) можно скачать тут:
https://huggingface.co/prompthero/openjourney/tree/main
Еще модели:
Ставьте stable-diffusion-webui Качайте mdjrny-v4.ckpt и пользуйтесь
А зачем вы аж четырёх художников перечислили подряд?
Забавно

Не знал что можно скрещивать стили. Нужно будет опробовать.
Пропорции 2:3 - портрет, 3:2 - пейзаж, 1:1 - сборная солянка
В промте можно указать portrait, sideface, upper_body или похожие по значению
С повышением шагов картинка действительно улучшается, руки, ноги, пальцы улучшаются. Но только для Sampling method без приставки adaptation (буква а в конце названия), иначе те могут полностью менять картинки при увеличении количества шагов.
С пальцами, ушами и глазами всё просто. Картинку отправляем в Inpaint. Выделяем непотребство и крутим до посинения, не трогая основную часть.
Вообще-то использование моделей stable diffusion в коммерческих целях запрещено
И это при том что я сам ещё не всё знаю о stable diffusion 
она будет работать и при 4 гб. Просто доступный размер картинок станет меньше и дольше генерация
Есть такое. Некоторые недочёты можно только руками исправить.
Взрослую довольно сложно сделать. Особенно офигенной 
Бонус от меня
Из бесплатных лучше всего Google Docs + LanguageTool в качестве расширения
Из апскейлов лучше всего работает SwinIR 4x
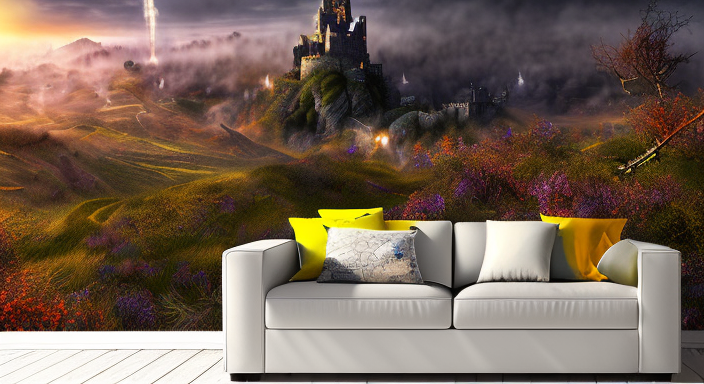
а теперь 4х

Мне бесплатного режима с Picky mode хватает
За наводку на Protogen огромное спасибо.
Если обоснуете соседство некромантии и кибертехнологий, то по почему бы и нет?
Первые два подходят разве что для Дроу
Там этих моделей на civitai больше сотни. Кроме Protogen скачал ещё парочку себе
Результатом доволен
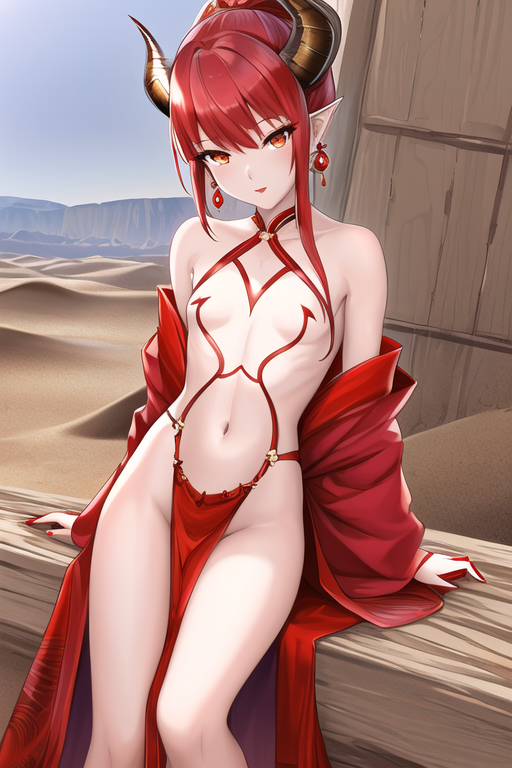
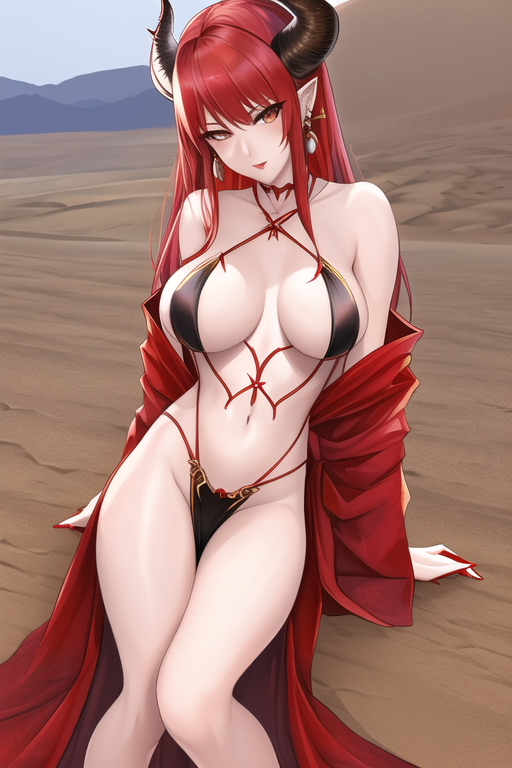
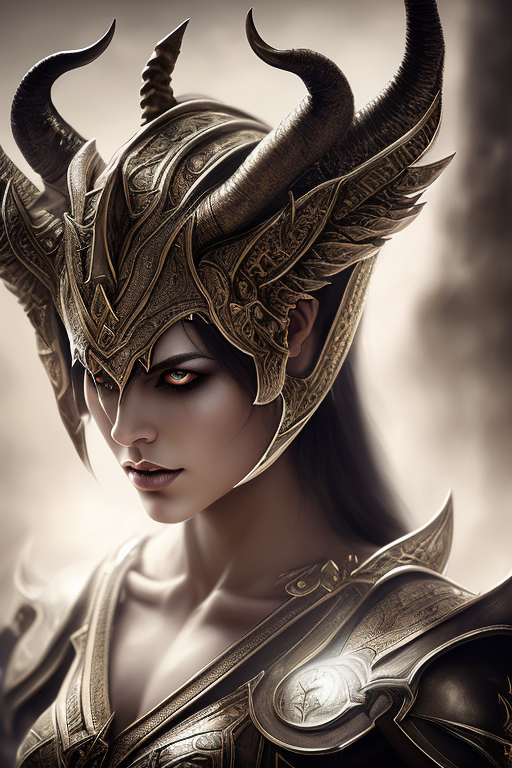
protogen V2.2
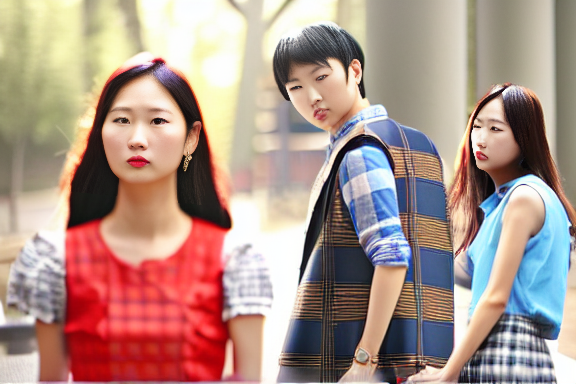
 1




Написал комментарий к посту О виртуальной реальности и играх будущего
Боюсь, что для получения полной реалистичности мощность имплантированного нейропроцессора нужна будет на уровне современных видеокарт (200Вт). Словосочетание "прожаренные мозги" заиграет новыми красками.
Думаю максимум что мы увидим это всплывающие окна с рекламой перед глазами или видеозвонок. Для большего потребуется отделение головы от тела. Сразу вспоминается "голова профессора Доуэля".