
Как модель читает промпт и почему не нужно генерить картинки из чата GPT напрямую
Автор: Кира ВерещагинаПроблема, которая взрывает мозг. Написали в чате GPT текст. Модель его съела. Попросили сгенерить иллюстрацию — сначала дать промпт. Модель дала. Попросили сгенерить картинку. Получили шляпу — не обязательно нейрослоп с кашей из пальцев. Просто задание не выполнено. Наблюдательные люди видят иногда тени предыдущей беседы в вожделенной картинке и спрашивают, какого чёрта.
На самом деле, вся ситуация заряжена пользователем с самого начала. Что нужно помнить, когда приходите в чат.
- Модель физически не присутствует в чате. Для текстовой LLM-модели (которая управляет графикой в чате) не существует прошлого. Каждый раз, когда вы отправляете новое сообщение, диалог «рождается заново». Рыбку Дори из «Немо» помните? Да, LLM высокого уровня «думает» именно так.
- Чтобы модель поддерживала линию беседы, разрабы применили хитрый трюк: каждый раз, когда вы нажимаете Enter, чат незаметно склеивает всю историю сообщений в один гигантский текст и отправляет его модели целиком.
Как это выглядит на практике и какие последствия имеет?
- Вы пишете:
Нарисуй кота.→Модель получает:[Нарисуй кота.] - Вы пишете:
Сделай его рыжим.→ Модель получает:[Нарисуй кота. Вот получилась картинка(изучает картинку). Сделай его рыжим.] - Вы пишете:
Нет, давай лучше пса.
→ Модель получает:[Нарисуй кота. Вот картинка (изучает картинку). Сделай его рыжим.Вот картинка(изучает картинку). Нет, давай лучше пса. ]
Вся эта огромная портянка текста превращается в токены (числа) и одновременно загружается в «мозг» модели при каждой новой генерации.
Кстати, если модель мультимодальная (одновременно может анализировать как текст, так и графику и кино, например), вы с каждым новым Enter пришиваете к запросу не только хвост из предыдущих запросов, но и картинок. Модель же считывает и анализирует всё. Со всеми прелестями LLM: ограниченностью контекстного окна, «забыванием середины» (attention soup) и триггерами внутренней цензуры. Добро пожаловать в Зазеркалье. Вам понятно, что нужно рисовать вместо рыжего кота собаку. Модели — что нужно нарисовать кота, но на самом деле рыжего и не нужно, а нужно собаку. О коте она забыть не может в силу своей природы.
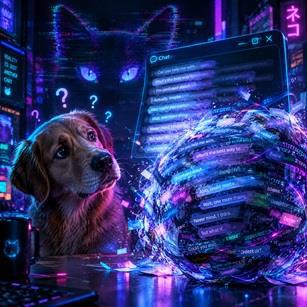
Поэтому не удивляйтесь, если после всех Ваших игрищ в диалоге на заднем плане изображения собаки Вам ехидно подмигивает кот, а у почему-то рыжей собаки могут оказаться кошачьи уши.
Но это ещё не всё. Если Вы генерите по большому тексту, и в нём есть триггеры — слова, которые модель обучена воспринимать как признак опасного контента, LLM просто вынуждена тщательно проверять диалог. Её внимание рассеивается, с конкретной задачи — создать промпт для изображения, она переключается на поиск всякого мусора и переформулировку промпта безопасным образом. Это всё за счёт контекстного окна. Качество промпта падает.
И таки да,LLM всегда дописывают Ваши промпты. Как они это делают, Вы не видите и не контролируете: как только нажата волшебная кнопка, задание улетело в неведомые поля Силиконовой долины обработки, токенизации, развесовки, вычисления векторов и прочих технических чудес, неподъёмных для человеческого восприятия. Поэтому мысли должны быть простыми и их нужно облекать в недвусмысленные формулировки.
Что же делать? Как только промпт Вас устраивает, открываете новый чат, и копируете результат в него. Тем самым Вы принудительно обрываете вязкую беседу. Модель в теории больше не помнит ничего, кроме задания, на котором, наконец, может сосредоточиться полностью и подготовить промпт для графической модели надлежащим образом. Генерить будет другая модель — графическая. Она не понимает текста и не хочет, чтобы он был. Для неё существует только набор токенов, которые она обсчитает и на основе их превратит белый шум в окошке экрана в пикселы цвета и света. Так не нужно портить эту и без того хрупкую связку между человеческим языком и токенами!
Тем, кто работает для создания промпта с Gemini и Claude, этого достаточно: эти модели понимают, что если чат новый, им необходимо обнулить контекст. Тем, кто работает с GPT, лайфхака может оказаться недостаточно: модель запоминает плюс-минус круг интересов пользователя и наводит на его задачи тени своих знаний. Здесь лучше бы сменить аккаунт, точнее завести чистый профиль только под генерацию.
Отсюда важные выводы:
- Не разбодяживайте беседы с ИИ на пять экранов. Максимум три цикла. Всё.
- Правило: не тяните в генерацию все Ваши рассуждения (не перегружайте описание), не отягчайте свою карму. Перед «Изобрази...» не должно быть ничего, а за этим словом — ничего, кроме промпта.
- Следите за языком. Перечень тем, которых нельзя касаться в чате, секрет Полишинеля.
И самый важный совет: никогда не генерите в обычных чатах финишные кадры для серьезных проектов. Для мимолетных идей чат сойдет. Для работы — выдвигаетесь напрямую в API графических моделей (Midjourney, Stable Diffusion) или используйте специализированные агрегаторы. Там графический движок получает чистые токены без «галлюцинаций» текстового ассистента.
Не наделяйте ИИ человеческими качествами, знайте его слабые места, и будет вам счастье.